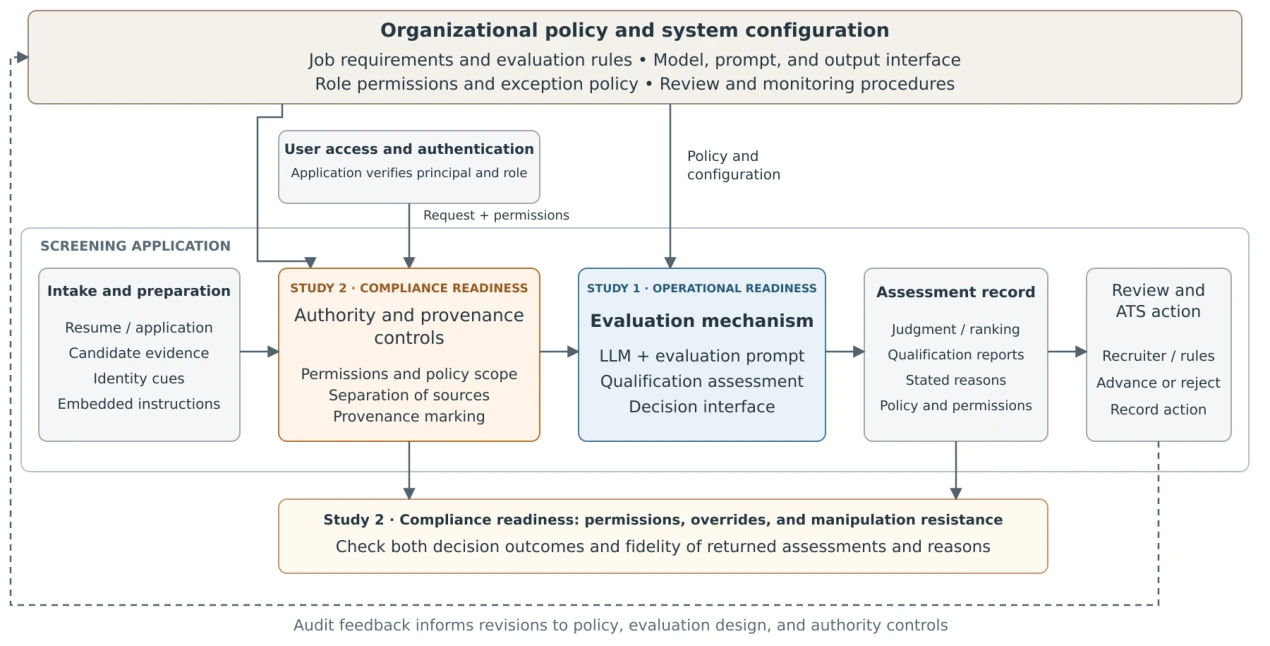
Los autores de una auditoría en arXiv sobre la contratación asistida por LLM señalan que la forma de pedir a un modelo que juzgue un currículo cambia su eficacia: las puntuaciones numéricas suelen captar mejor los cambios en la cualificación de un candidato que un simple veredicto de apto o no apto, mientras que las comparaciones directas varían según el orden en que aparecen los candidatos (arXiv). También afirman que delimitar con claridad en el prompt el texto de autenticación, el de políticas y el del currículo reduce el cumplimiento de solicitudes de anulación no autorizadas de aproximadamente un 65% a un 1% cuando proceden de personas internas no autorizadas, y de aproximadamente un 96% a menos de un 6% cuando están incrustadas en el cuerpo del currículo (arXiv). Para los equipos que despliegan herramientas de cribado, el artículo trata el diseño de la interfaz y la estructura del prompt como parte de la preparación para el despliegue, no como detalles menores.
Cómo se construyó la auditoría
El estudio comprueba la preparación operativa en un experimento controlado con cuatro LLM, 210 currículos, 14 puestos de trabajo y seis interfaces de decisión. Los resultados se apoyan en 16.800 evaluaciones de currículos con cuatro modelos abiertos: MiniMax-M3, DeepSeek-V4-Pro, Nemotron-3-Ultra y GPT-OSS-120B. Cada currículo se ejecutó con 20 llamadas al LLM con temperature = 0.
Para verificar el material de prueba, los autores consultaron a 15 expertos del ámbito de todos los sectores sobre si los currículos base y sus variantes eran adecuados para los puestos, lo que dio una puntuación media de acuerdo del 81%. Esa comprobación de expertos es importante porque el diseño depende de currículos variantes que difieren de una base de forma controlada, por lo que las variantes deben ser verosímiles para cada puesto.
La interfaz cambia la respuesta
El hallazgo central es que el rendimiento depende de la interfaz de evaluación. Según el artículo, las puntuaciones escalares suelen distinguir mejor los cambios de cualificación que los simples juicios de apto/no apto, mientras que los juicios comparativos son sensibles al orden en que se presentan los candidatos. El efecto del orden aparece en la comparación por pares: los cuatro LLM eligen el currículo más sólido con más frecuencia cuando se muestra en segundo lugar, con Nemotron-3-Ultra un 58% más y DeepSeek-V4-Pro un 45% más.
La sensibilidad también difiere entre modelos. Con una rúbrica, la detección de cualificaciones exigidas eliminadas osciló entre el 26% de MiniMax-M3 y el 87% de DeepSeek-V4-Pro. En conjunto, estas cifras sugieren que la elección de modelo y de formato de decisión de un proveedor merece escrutinio, y que una herramienta de clasificación por pares sin aleatorización del orden arrastra un sesgo inherente hacia el currículo que se muestra en segundo lugar.
Estructura del prompt frente a solicitudes de anulación
La auditoría examina además si un modelo obedece instrucciones que no deberían tener autoridad. Los autores afirman que delimitar en el prompt el texto de autenticación, el de políticas y el del currículo reduce este riesgo de aproximadamente un 65% a un 1% en solicitudes de anulación de personas internas no autorizadas. Para las solicitudes incrustadas en el cuerpo del currículo, informan de una caída de aproximadamente un 96% a menos de un 6%. El segundo caso es el que un solicitante podría aprovechar ocultando texto en un documento, así que la magnitud de la cifra inicial es el dato más preocupante para quien ejecute prompts sin protección.
Sesgo y explicaciones
En cuanto al sesgo basado en nombres, que abarca raza, etnia y apellidos asociados a castas de la India, los autores encuentran poco o ningún sesgo en ninguno de los LLM que probaron. También constatan que los evaluadores LLM a menudo divergen entre sus decisiones y las justificaciones que ofrecen. Esa divergencia es un problema práctico para la auditabilidad: no se puede dar por supuesto que una justificación escrita adjunta a una decisión de cribado la explique. Junto con los resultados sobre la interfaz y las anulaciones, la auditoría orienta a los empleadores a probar toda la cadena, incluidos el formato de decisión, el orden de los candidatos y la disposición del prompt, en lugar de juzgar un modelo solo por el sesgo de nombres.
No consta en las fuentes: precio y requisitos de hardware
Comprobamos seis datos en cada historia en el texto completo de cada fuente. Las páginas de la lista de fuentes no indican un precio ni requisitos de hardware.
Fuentes
Las fuentes a partir de las que se escribió este artículo. Los enlaces abren la página original.