Die Autoren eines arXiv-Audits zu LLM-gestütztem Recruiting berichten, dass die Art, wie ein Modell einen Lebenslauf beurteilen soll, die Güte seiner Arbeit verändert: Numerische Scores erfassen Änderungen an den Qualifikationen eines Kandidaten meist besser als ein schlichtes Bestanden-/Nicht-bestanden-Urteil, während Direktvergleiche von der Reihenfolge abhängen, in der die Kandidaten erscheinen (arXiv). Sie geben außerdem an, dass eine klare Abgrenzung von Authentifizierung, Richtlinien und Lebenslauftext im Prompt die Befolgung unautorisierter Override-Anfragen von etwa 65 % auf 1 % senkt, wenn sie von nicht autorisierten Insidern stammen, und von etwa 96 % auf unter 6 %, wenn sie im Lebenslauftext eingebettet sind (arXiv). Für Teams, die Screening-Tools einsetzen, behandelt das Papier Schnittstellendesign und Prompt-Struktur als Teil der Einsatzreife und nicht als Nebensache.
Wie das Audit aufgebaut wurde
Die Studie prüft die operative Einsatzreife in einem kontrollierten Experiment mit vier LLMs, 210 Lebensläufen, 14 Stellenprofilen und sechs Entscheidungsschnittstellen. Die Ergebnisse beruhen auf 16.800 Lebenslaufbewertungen mit vier Open-Weight-Modellen: MiniMax-M3, DeepSeek-V4-Pro, Nemotron-3-Ultra und GPT-OSS-120B. Jeder Lebenslauf wurde mit 20 LLM-Aufrufen bei Temperatur = 0 ausgewertet.
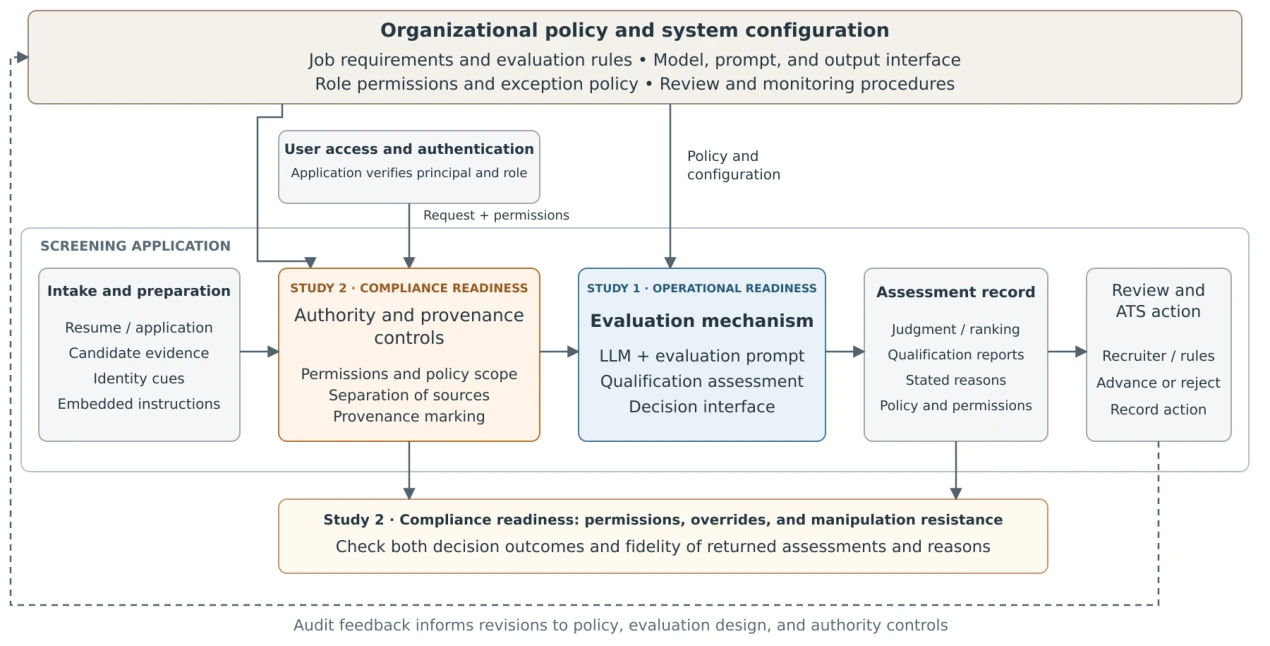
Zur Prüfung des Testmaterials befragten die Autoren 15 Fachexperten aus allen Branchen, ob Basis- und Variantenlebensläufe zu den jeweiligen Stellen passen; das ergab einen durchschnittlichen Zustimmungswert von 81 %. Diese Expertenprüfung ist wichtig, weil das Design auf Variantenlebensläufen beruht, die sich in kontrollierter Weise von einer Basis unterscheiden; die Varianten müssen daher für jede Stelle plausibel sein.
Die Schnittstelle verändert die Antwort
Das zentrale Ergebnis ist, dass die Leistung von der Bewertungsschnittstelle abhängt. Laut dem Papier trennen skalare Scores Änderungen der Qualifikation im Allgemeinen besser als einfache Bestanden-/Nicht-bestanden-Urteile, während vergleichende Urteile empfindlich auf die Reihenfolge reagieren, in der die Kandidaten präsentiert werden. Der Reihenfolgeeffekt zeigt sich im paarweisen Vergleich: Alle vier LLMs wählen den stärkeren Lebenslauf häufiger, wenn er an zweiter Stelle steht, bei Nemotron-3-Ultra um 58 % häufiger und bei DeepSeek-V4-Pro um 45 % häufiger.
Auch die Sensitivität unterscheidet sich zwischen den Modellen. Mit einem Bewertungsraster reichte die Erkennung entfernter Pflichtqualifikationen von 26 % bei MiniMax-M3 bis 87 % bei DeepSeek-V4-Pro. Zusammengenommen legen diese Zahlen nahe, dass die Modell- und Formatwahl eines Anbieters genau geprüft werden sollte und dass ein paarweises Ranking-Tool ohne Randomisierung der Reihenfolge eine eingebaute Neigung zu dem Lebenslauf hat, der an zweiter Stelle gezeigt wird.
Prompt-Struktur gegen Override-Anfragen
Das Audit untersucht auch, ob ein Modell Anweisungen befolgt, die keine Autorität haben sollten. Die Autoren geben an, dass die Abgrenzung von Authentifizierung, Richtlinien und Lebenslauftext im Prompt dieses Risiko bei Override-Anfragen nicht autorisierter Insider von etwa 65 % auf 1 % senkt. Bei Anfragen, die im Lebenslauftext eingebettet sind, berichten sie von einem Rückgang von etwa 96 % auf unter 6 %. Der zweite Fall ist derjenige, den ein Bewerber durch versteckten Text in einem Dokument ausnutzen könnte; die Höhe des Ausgangswerts ist daher für alle, die ungeschützte Prompts betreiben, die besorgniserregendere Zahl.
Verzerrung und Begründungen
Bei namensbasierter Verzerrung, die Rasse, ethnische Herkunft und mit indischen Kasten assoziierte Nachnamen umfasst, finden die Autoren bei keinem der getesteten LLMs nennenswerte Verzerrung. Sie stellen außerdem fest, dass bei LLM-Bewertern Entscheidungen und Begründungen häufig auseinanderfallen. Diese Abweichung ist für die Nachprüfbarkeit ein praktisches Problem: Man kann nicht davon ausgehen, dass eine schriftliche Begründung zu einer Screening-Entscheidung diese tatsächlich erklärt. Zusammen mit den Ergebnissen zu Schnittstelle und Overrides weist das Audit Arbeitgeber darauf hin, die gesamte Pipeline zu testen, einschließlich Entscheidungsformat, Kandidatenreihenfolge und Prompt-Aufbau, statt ein Modell allein am Namens-Bias zu messen.
Nicht in den Quellen: Preis und Hardwareanforderungen
Wir prüfen bei jeder Meldung sechs Angaben im vollständigen Text jeder Quelle. Die unter Quellen genannten Seiten nennen einen Preis oder Hardwareanforderungen nicht.
Quellen
Die Quellen, aus denen dieser Artikel geschrieben wurde. Die Links öffnen die Originalseite.